De plus en plus de questions sont posées à un assistant plutôt qu'à un moteur de recherche classique. La réponse arrive rédigée, avec quelques liens vers les pages qui l'appuient. Pour une entreprise, la question devient : comment faire partie de ces pages ? Beaucoup d'offres promettent d'y répondre. Cet article fait le tri entre ce que les éditeurs de ces outils ont écrit noir sur blanc et ce qui relève de l'hypothèse, puis donne les actions concrètes à mener sur un site d'entreprise.
Qu'est-ce que le référencement IA, ou GEO ?
Le GEO, pour Generative Engine Optimization, désigne le travail pour qu'un site soit repris comme source par les moteurs de réponse : les aperçus IA et le mode IA de Google, l'assistant Gemini, ChatGPT avec sa fonction de recherche, Perplexity. Ces services rédigent une réponse, puis citent ou mettent en lien des pages. Ils ne fonctionnent pas tous de la même façon, et ne publient pas tous les mêmes informations sur la manière dont ils choisissent leurs sources.
Le GEO ne remplace pas le référencement naturel : il s'appuie dessus. Notre guide de la stratégie SEO en donne le cadre général ; cet article détaille la partie propre aux moteurs de réponse.
Ce qui est établi, moteur par moteur
Google : aperçus IA et mode IA
Google a publié une page dédiée à ces fonctions dans sa documentation Search Central. Pour qu'une page puisse y apparaître, elle doit être indexée et pouvoir s'afficher avec un extrait dans la recherche ; Google précise qu'il n'y a aucune exigence technique supplémentaire ni optimisation spéciale. Il écrit aussi qu'il n'est pas nécessaire de créer des fichiers lisibles par une machine, des fichiers texte pour l'IA, ni des données structurées particulières.
Les recommandations sont celles du référencement habituel : autoriser l'exploration dans le fichier robots.txt et dans l'infrastructure d'hébergement, rendre les contenus importants disponibles sous forme de texte, faire correspondre les données structurées au texte visible, tenir à jour sa fiche d'établissement. Les commandes nosnippet, max-snippet ou noindex limitent ce que Google peut reprendre. Enfin, les visites venues de ces fonctions sont comptées dans le rapport Performances de la Search Console, avec le reste du trafic de type « Web ».
Gemini
Google documente un jeton à placer dans le fichier robots.txt, Google-Extended. Il permet de refuser que vos contenus servent à entraîner les futures générations de modèles Gemini, et à l'ancrage, c'est-à-dire la fourniture de contenus au modèle au moment de la question, dans les applications Gemini et Vertex AI. Google précise que Google-Extended n'a aucune incidence sur l'inclusion d'un site dans la recherche Google et n'est pas un signal de classement.
ChatGPT
OpenAI décrit ses robots dans sa documentation. OAI-SearchBot sert à faire apparaître des sites dans les fonctions de recherche de ChatGPT : un site qui le bloque n'est pas montré dans les réponses de recherche, même s'il peut encore apparaître sous forme de simple lien de navigation. GPTBot collecte des contenus qui peuvent servir à entraîner les modèles d'OpenAI. Les deux réglages sont indépendants : vous pouvez autoriser l'un et bloquer l'autre. ChatGPT-User visite une page à la demande d'un utilisateur, et OpenAI indique que les règles du robots.txt peuvent ne pas s'y appliquer. Un changement du robots.txt met environ 24 heures à être pris en compte pour la recherche.
Perplexity
Perplexity documente deux robots. PerplexityBot sert à faire apparaître et à mettre en lien des sites dans ses résultats ; Perplexity recommande de l'autoriser dans le robots.txt et précise qu'il ne sert pas à collecter des contenus pour entraîner des modèles. Perplexity-User visite une page quand un utilisateur pose une question et, selon Perplexity, ignore en général le robots.txt puisque la visite est demandée par l'utilisateur. Un changement peut mettre jusqu'à 24 heures à être pris en compte.
| Service | Robot à laisser passer | Entraînement des modèles |
|---|---|---|
| Google, aperçus IA | Googlebot | Aucun réglage propre |
| Gemini | Googlebot | Jeton Google-Extended |
| ChatGPT | OAI-SearchBot | GPTBot, réglage séparé |
| Perplexity | PerplexityBot | Non, selon Perplexity |
Ce qui n'est pas établi
- Les critères de choix des sources. Aucun de ces services ne publie de règle qui dirait pourquoi une page est citée plutôt qu'une autre. Les études publiées sur le sujet décrivent des observations, pas des règles fixées par ces services.
- Une place garantie. Personne ne peut garantir qu'un site sera cité, ni à quelle fréquence. Les réponses changent selon la formulation de la question, l'utilisateur et le moment.
- L'effet du fichier llms.txt. C'est une proposition publiée en septembre 2024 par Jeremy Howard, présentée par son site comme une proposition de standard, pas comme un standard adopté. Google écrit qu'aucun fichier de ce type n'est nécessaire pour ses aperçus IA. Les pages d'OpenAI et de Perplexity consacrées à leurs robots, consultées le 14 octobre 2026, n'en parlent pas.
- Une mesure complète. La Search Console ne sépare pas les visites venues des aperçus IA du reste du trafic, et les pages d'OpenAI et de Perplexity consacrées à leurs robots ne mentionnent aucun rapport équivalent pour les sites.
Une règle simple pour trier les offres
Demandez sur quelle documentation officielle repose chaque action proposée. Si la réponse est une étude maison, un « algorithme » non publié ou une garantie de citation, vous savez ce que vaut la promesse.
Faut-il bloquer les robots des IA ?
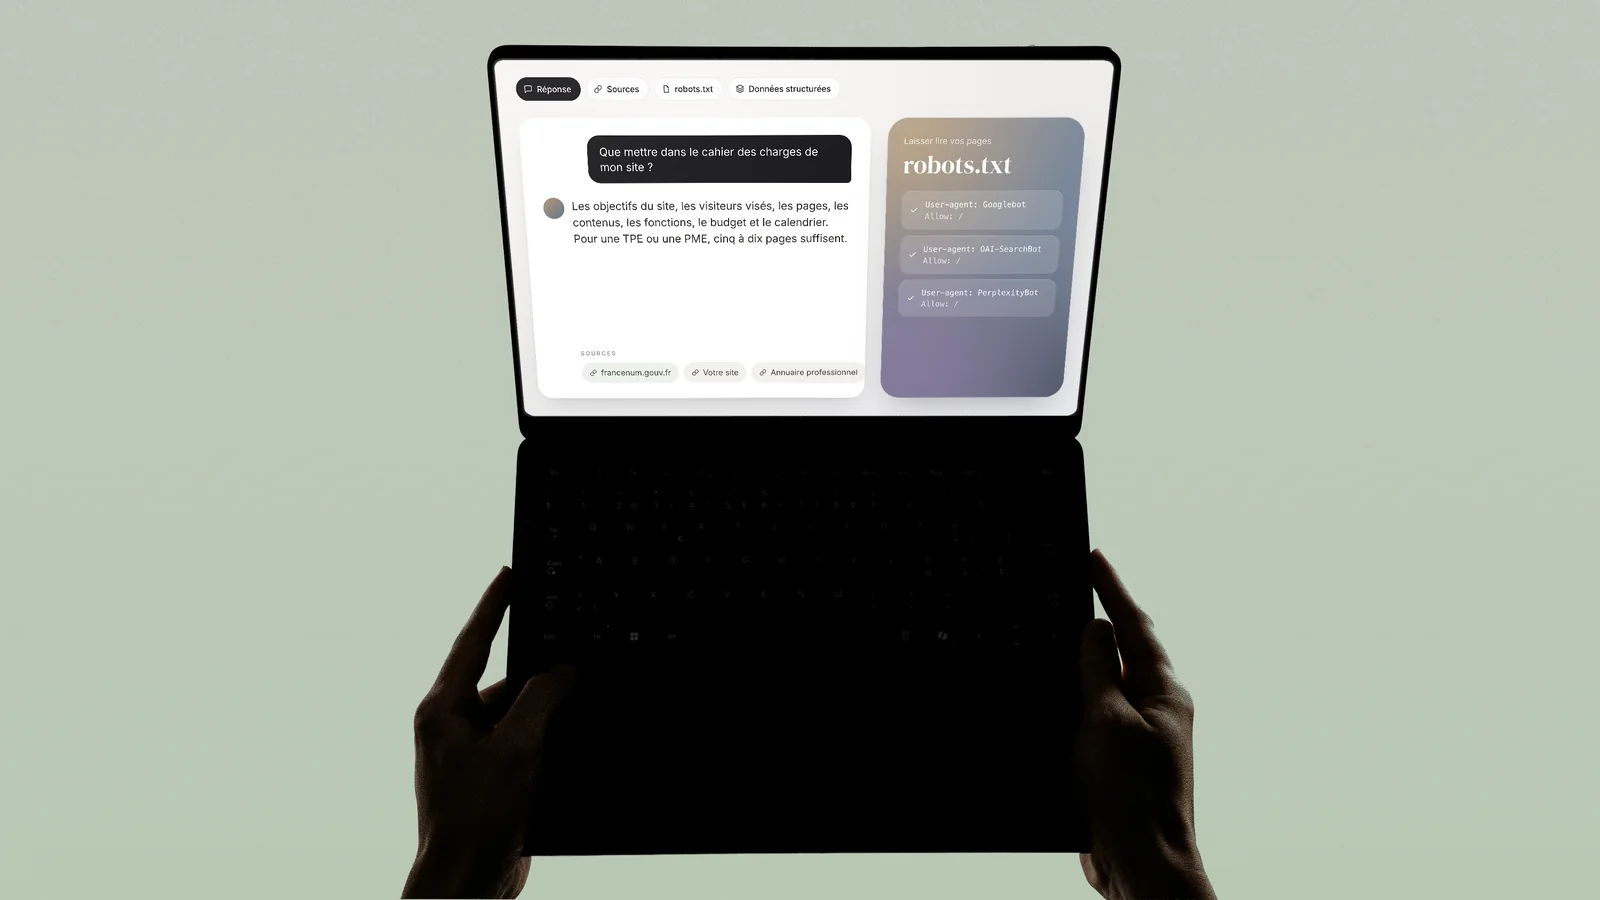
C'est un choix, qui se fait robot par robot. Si vous voulez apparaître dans les réponses, laissez passer les robots de recherche : Googlebot, OAI-SearchBot, PerplexityBot. Si vous ne voulez pas que vos textes servent à l'entraînement des modèles, vous pouvez bloquer GPTBot ou utiliser le jeton Google-Extended, en sachant que ce dernier règle aussi l'ancrage dans les applications Gemini. Bloquer Googlebot, en revanche, retire votre site de la recherche Google tout entière.
Vérifiez aussi ce que vous ne voyez pas : un pare-feu ou un réseau de diffusion de contenu peut bloquer des robots sans que le robots.txt le dise. Google rappelle que l'exploration doit être autorisée dans le robots.txt et dans l'infrastructure d'hébergement. Demandez à votre prestataire ou à votre hébergeur ce qui est filtré.
Les actions concrètes pour un site d'entreprise
1. Laisser les robots lire vos pages
Relisez votre robots.txt : il ne doit pas bloquer les robots de recherche que vous voulez accueillir. Assurez-vous que vos informations importantes sont écrites en texte, et non seulement dans des images ou des PDF, et que chaque page est accessible par un lien depuis une autre page du site.
2. Écrire des pages qui répondent clairement
Une page par sujet, un intertitre qui pose la question, une réponse courte et complète en tête, puis le détail. Donnez des faits précis et vérifiables : ce que vous faites, pour qui, où, à quel prix de départ, dans quel délai. Google invite à créer des contenus utiles et fiables, écrits d'abord pour les personnes ; c'est aussi ce qui se cite le plus facilement. Notre guide du copywriting web donne la méthode pour vos textes.
3. Ajouter des données structurées exactes
Les données structurées décrivent votre entreprise dans un format que les machines lisent sans ambiguïté. Pour l'entité elle-même, Google documente le type Organization : nom, adresse du site, logo, adresse postale, téléphone et liens vers vos profils officiels (sameAs). Aucune propriété n'est obligatoire, et ces données se placent sur la page d'accueil ou une page « À propos ». Pour un commerce ou un cabinet qui reçoit du public, le type LocalBusiness ajoute les horaires et l'adresse. Une règle s'applique à toutes : ce qui est déclaré doit correspondre au texte visible de la page.
4. Soigner ce qui est écrit sur vous ailleurs
Une réponse générée s'appuie sur des pages qu'elle cite, et ces pages ne sont pas toujours les vôtres : annuaires professionnels, fiches d'établissement, articles, comparatifs, avis. Veillez à ce que les informations qui vous concernent soient exactes et identiques partout : nom, adresse, téléphone, activité, zone servie. Commencez par votre fiche d'établissement Google, que Google cite parmi les informations à tenir à jour ; notre guide de la fiche d'établissement détaille chaque rubrique. Les liens obtenus honnêtement auprès de sites reconnus de votre secteur restent utiles, comme l'explique notre article sur les backlinks.
5. Publier un llms.txt, en sachant ce qu'il vaut
Le fichier llms.txt, placé à la racine du site, est un document au format Markdown : un titre avec le nom du site, un court résumé, puis des listes de liens vers les pages utiles. Il ne coûte presque rien à produire s'il est généré automatiquement à partir du site. Publiez-le si vous le souhaitez, mais n'en attendez aucun effet garanti : ce n'est pas un standard, et Google indique ne pas en avoir besoin.
6. Mesurer ce qui peut l'être
Suivez l'évolution de vos clics et de vos impressions dans la Search Console, qui inclut les aperçus IA et le mode IA. Regardez dans votre outil de mesure d'audience les sites d'où viennent vos visiteurs : quand un visiteur clique sur un lien depuis un assistant, le domaine de celui-ci peut y apparaître. Google conseille de juger la valeur des visites, ventes, demandes ou inscriptions, plutôt que leur seul nombre. Notre guide de Google Analytics 4 explique où lire ces chiffres. Vous pouvez aussi poser régulièrement à ces assistants les questions de vos clients et noter les sources citées, en gardant à l'esprit que les réponses varient.
Les promesses à refuser
- Une citation garantie dans ChatGPT, Perplexity ou les aperçus IA de Google.
- Un fichier ou un balisage « spécial IA » présenté comme indispensable.
- Des dizaines de pages produites en série pour couvrir toutes les questions possibles, sans information nouvelle.
- Un tableau de bord qui prétend mesurer précisément votre « part de voix » dans les assistants, sans dire comment.
Ces promesses ressemblent à celles du référencement classique, et la réponse est la même : Google indique que personne ne peut garantir la première position dans ses résultats. Les mêmes précautions valent pour les réponses des IA.
Ce que DMA Digital fait sur ce sujet
Chaque site que nous créons inclut un référencement technique : un titre et une description pour chaque page, des adresses claires, un chargement rapide sur téléphone et un lien avec votre fiche d'établissement Google. Ce sont les bases que Google demande aussi pour ses aperçus IA. Nous ne promettons ni position sur Google ni citation par une IA : nous sommes tenus à une obligation de moyens.
Pour savoir ce que les robots peuvent lire aujourd'hui sur votre site, demandez notre audit gratuit. Pour un nouveau site ou une refonte, nos prix de départ sont sur chaque page d'expertise : site vitrine dès 5 000 € HT, site e-commerce dès 8 000 € HT. Vous pouvez aussi prendre rendez-vous pour en parler.
Questions fréquentes
Comment apparaître dans les réponses de ChatGPT ?
OpenAI indique que son robot OAI-SearchBot sert à faire apparaître des sites dans la recherche de ChatGPT : il doit pouvoir lire vos pages, donc ne pas être bloqué dans votre robots.txt ni par votre hébergement. Ensuite, aucune règle de citation n'est publiée. Des pages claires, précises et à jour, et des informations exactes sur vous ailleurs, restent ce que vous maîtrisez.
Faut-il un fichier llms.txt pour être cité par les IA ?
Non. Le fichier llms.txt est une proposition publiée en 2024, pas un standard adopté. Google écrit qu'aucun fichier de ce type n'est nécessaire pour apparaître dans ses aperçus IA et son mode IA, et les pages d'OpenAI et de Perplexity consacrées à leurs robots n'en parlent pas. Vous pouvez le publier, sans en attendre d'effet garanti.
Le GEO remplace-t-il le référencement naturel ?
Non, il s'appuie dessus. Pour ses aperçus IA, Google demande qu'une page soit indexée et puisse s'afficher avec un extrait, sans optimisation spéciale : ce sont les conditions du référencement naturel. Les autres moteurs de réponse doivent eux aussi pouvoir lire vos pages. Un site lisible, rapide et clair sert les deux à la fois.
Bloquer GPTBot empêche-t-il d'apparaître dans ChatGPT ?
Non, selon OpenAI. GPTBot collecte des contenus qui peuvent servir à entraîner ses modèles, alors qu'OAI-SearchBot sert à la recherche de ChatGPT. Les deux réglages sont indépendants : vous pouvez bloquer GPTBot et autoriser OAI-SearchBot. Bloquer OAI-SearchBot, en revanche, retire votre site des réponses de recherche de ChatGPT.
Peut-on mesurer les visites venues des IA ?
En partie seulement. La Search Console compte les clics venus des aperçus IA et du mode IA avec le reste du trafic « Web », sans les isoler. Dans votre outil de mesure d'audience, les visites issues d'un lien cliqué dans un assistant peuvent apparaître avec le domaine de celui-ci parmi les sites référents. Jugez surtout les demandes et les ventes qui en résultent.
Sources
- Fonctionnalités d'IA et votre site Web (aperçus IA et mode IA), Google Search Central, 31 décembre 2025
- Top ways to ensure your content performs well in Google's AI experiences on Search, Google Search Central Blog, 21 mai 2025
- Robots d'exploration communs de Google (Google-Extended), Google for Developers, 16 septembre 2026
- Overview of OpenAI Crawlers, OpenAI
- Perplexity Crawlers, Perplexity
- The /llms.txt file, Jeremy Howard (llmstxt.org), 3 septembre 2024
- Données structurées Organization, Google Search Central, 12 septembre 2026
- Données structurées spécifiques aux établissements locaux (LocalBusiness), Google Search Central, 12 septembre 2026
- Créer des contenus utiles, fiables et people-first, Google Search Central, 7 octobre 2026
- Avez-vous besoin d'un référenceur ? Conseils pour embaucher un référenceur, Google Search Central, 9 juin 2026